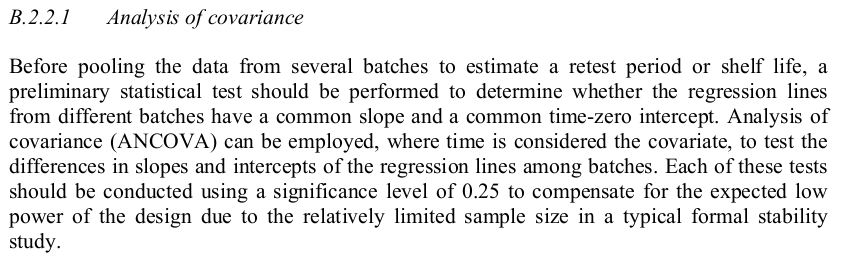
<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="4.3.4">Jekyll</generator><link href="/feed.xml" rel="self" type="application/atom+xml" /><link href="/" rel="alternate" type="text/html" /><updated>2026-09-09T03:03:41+00:00</updated><id>/feed.xml</id><title type="html">Éderson D’Martin Costa, PhD</title><subtitle>Éderson D&apos;Martin Costa é Doutor em Química  com pós-doutorado em Química Teórica/Computacional e  Modelagem Estatística/Estatística Computacional. </subtitle><entry><title type="html">Teste para Agrupamento de Lotes em Estudos de Estabilidade (ANCOVA) e Tempo de Prateleira</title><link href="/2026/09/08/ancova.html" rel="alternate" type="text/html" title="Teste para Agrupamento de Lotes em Estudos de Estabilidade (ANCOVA) e Tempo de Prateleira" /><published>2026-09-08T23:41:00+00:00</published><updated>2026-09-08T23:41:00+00:00</updated><id>/2026/09/08/ancova</id><content type="html" xml:base="/2026/09/08/ancova.html"><![CDATA[<p>O ICH Topic Q 1 E (<em>Evaluation of Stability Data</em>) apresenta o trecho abaixo, que descreve o procedimento estatístico recomendado para decidir se os dados de diferentes lotes podem ser agrupados em uma análise de estabilidade:</p>

<p><img src="/images/ichq1e.png" alt="Figura" /></p>

<p>Como exercício de aprendizagem para esse procedimento estatístico, vamos reproduzir um exemplo completo em R: da análise de covariância (ANCOVA) até a estimativa do tempo de prateleira (<em>shelf life</em>).</p>

<h2 id="os-dados">Os dados</h2>

<p>Considere os dados abaixo, que apresentam o teor (Resp) como percentual do valor declarado, medido em três tempos (0, 3 e 6 meses) para três lotes (1, 2 e 3). Cada lote possui três réplicas em cada tempo.</p>

<div class="language-R highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">df</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">data.frame</span><span class="p">(</span><span class="w">
  </span><span class="n">Resp</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="w">
    </span><span class="m">99.54</span><span class="p">,</span><span class="w"> </span><span class="m">99.19</span><span class="p">,</span><span class="w"> </span><span class="m">100.36</span><span class="p">,</span><span class="w">
    </span><span class="m">100.07</span><span class="p">,</span><span class="w"> </span><span class="m">99.10</span><span class="p">,</span><span class="w"> </span><span class="m">100.65</span><span class="p">,</span><span class="w">
    </span><span class="m">99.86</span><span class="p">,</span><span class="w"> </span><span class="m">99.71</span><span class="p">,</span><span class="w"> </span><span class="m">99.21</span><span class="p">,</span><span class="w">
    </span><span class="m">99.63</span><span class="p">,</span><span class="w"> </span><span class="m">98.86</span><span class="p">,</span><span class="w"> </span><span class="m">100.32</span><span class="p">,</span><span class="w">
    </span><span class="m">99.02</span><span class="p">,</span><span class="w"> </span><span class="m">100.31</span><span class="p">,</span><span class="w"> </span><span class="m">98.51</span><span class="p">,</span><span class="w">
    </span><span class="m">98.81</span><span class="p">,</span><span class="w"> </span><span class="m">99.65</span><span class="p">,</span><span class="w"> </span><span class="m">100.43</span><span class="p">,</span><span class="w">
    </span><span class="m">99.06</span><span class="p">,</span><span class="w"> </span><span class="m">98.29</span><span class="p">,</span><span class="w"> </span><span class="m">99.28</span><span class="p">,</span><span class="w">
    </span><span class="m">97.85</span><span class="p">,</span><span class="w"> </span><span class="m">98.35</span><span class="p">,</span><span class="w"> </span><span class="m">97.35</span><span class="p">,</span><span class="w">
    </span><span class="m">98.87</span><span class="p">,</span><span class="w"> </span><span class="m">98.79</span><span class="p">,</span><span class="w"> </span><span class="m">97.65</span><span class="w">
  </span><span class="p">),</span><span class="w">
  </span><span class="n">Tempo</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">rep</span><span class="p">(</span><span class="nf">c</span><span class="p">(</span><span class="m">0</span><span class="p">,</span><span class="w"> </span><span class="m">3</span><span class="p">,</span><span class="w"> </span><span class="m">6</span><span class="p">),</span><span class="w"> </span><span class="n">each</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">9</span><span class="p">),</span><span class="w">
  </span><span class="n">Lote</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">rep</span><span class="p">(</span><span class="nf">rep</span><span class="p">(</span><span class="m">1</span><span class="o">:</span><span class="m">3</span><span class="p">,</span><span class="w"> </span><span class="n">each</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">3</span><span class="p">),</span><span class="w"> </span><span class="n">times</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">3</span><span class="p">)</span><span class="w">
</span><span class="p">)</span><span class="w">

</span><span class="c1"># Converter Lote para fator</span><span class="w">
</span><span class="n">df</span><span class="o">$</span><span class="n">Lote</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">factor</span><span class="p">(</span><span class="n">df</span><span class="o">$</span><span class="n">Lote</span><span class="p">)</span><span class="w">

</span><span class="n">print</span><span class="p">(</span><span class="n">head</span><span class="p">(</span><span class="n">df</span><span class="p">))</span><span class="w">
</span></code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>    Resp Tempo Lote
1  99.54     0    1
2  99.19     0    1
3 100.36     0    1
4 100.07     0    2
5  99.10     0    2
6 100.65     0    2
</code></pre></div></div>

<h2 id="passo-1-testando-a-homogeneidade-das-inclinações">Passo 1: testando a homogeneidade das inclinações</h2>

<p>A análise pode ser feita com soma de quadrados (SQ) tipo I ou tipo III. Aqui usaremos a tipo I, que reproduz os resultados obtidos pelo Minitab, software amplamente usado nesse tipo de cálculo de estabilidade. Um detalhe importante é que, para dados balanceados como os deste exemplo, a SQ tipo I não depende da ordem dos termos no modelo.</p>

<p>No R, a análise de covariância (ANCOVA) é obtida pelo código abaixo. O termo de interação <code class="language-plaintext highlighter-rouge">Tempo*Lote</code> é incluído porque queremos, nesta primeira etapa, um ajuste com inclinações (<em>slopes</em>) e interceptos livres para cada lote:</p>

<div class="language-R highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># slope e intercepto livres para cada lote</span><span class="w">
</span><span class="n">modelo_completo</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">lm</span><span class="p">(</span><span class="n">Resp</span><span class="w"> </span><span class="o">~</span><span class="w"> </span><span class="n">Tempo</span><span class="w"> </span><span class="o">*</span><span class="w"> </span><span class="n">Lote</span><span class="p">,</span><span class="w"> </span><span class="n">data</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">df</span><span class="p">)</span><span class="w">
</span><span class="n">print</span><span class="p">(</span><span class="n">anova</span><span class="p">(</span><span class="n">modelo_completo</span><span class="p">))</span><span class="w">
</span></code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Analysis of Variance Table

Response: Resp
           Df Sum Sq Mean Sq F value    Pr(&gt;F)    
Tempo       1 8.2689  8.2689 18.2671 0.0003374 ***
Lote        2 0.6133  0.3066  0.6774 0.5187026    
Tempo:Lote  2 1.2987  0.6493  1.4345 0.2606467    
Residuals  21 9.5060  0.4527                      
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
</code></pre></div></div>

<p>Como o p-valor da interação <code class="language-plaintext highlighter-rouge">Tempo:Lote</code> (0,2606) é maior que o nível de significância de 0,25 recomendado pelo ICH Topic Q 1 E, não há evidência de que as inclinações difiram entre os lotes. Podemos, então, seguir para o modelo com inclinação única.</p>

<h2 id="passo-2-testando-a-homogeneidade-dos-interceptos">Passo 2: testando a homogeneidade dos interceptos</h2>

<p>Basta ajustar um novo modelo, agora sem o termo de interação, mantendo uma inclinação comum e interceptos livres por lote:</p>

<div class="language-R highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># slope em comum e intercepto livre por lote</span><span class="w">
</span><span class="n">modelo_slope_unico</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">lm</span><span class="p">(</span><span class="n">Resp</span><span class="w"> </span><span class="o">~</span><span class="w"> </span><span class="n">Tempo</span><span class="w"> </span><span class="o">+</span><span class="w"> </span><span class="n">Lote</span><span class="p">,</span><span class="w"> </span><span class="n">data</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">df</span><span class="p">)</span><span class="w">
</span><span class="n">print</span><span class="p">(</span><span class="n">anova</span><span class="p">(</span><span class="n">modelo_slope_unico</span><span class="p">))</span><span class="w">
</span></code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Analysis of Variance Table

Response: Resp
           Df  Sum Sq Mean Sq F value    Pr(&gt;F)    
Tempo       1  8.2689  8.2689 17.6021 0.0003459 ***
Lote        2  0.6133  0.3066  0.6527 0.5300062    
Residuals  23 10.8047  0.4698                      
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
</code></pre></div></div>

<p>Agora o p-valor para <code class="language-plaintext highlighter-rouge">Lote</code> (0,5300) também é maior que 0,25, ou seja, não há evidência de que os interceptos difiram entre os lotes. Isso significa que os três lotes podem ser agrupados em um único modelo.</p>

<h2 id="passo-3-modelo-final-com-lotes-agrupados">Passo 3: modelo final com lotes agrupados</h2>

<p>Com inclinação e intercepto comuns, o modelo final considera todos os lotes simultaneamente:</p>

<div class="language-R highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># slope e intercepto em comum para todos os lotes</span><span class="w">
</span><span class="n">modelo_agrupado</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">lm</span><span class="p">(</span><span class="n">Resp</span><span class="w"> </span><span class="o">~</span><span class="w"> </span><span class="n">Tempo</span><span class="p">,</span><span class="w"> </span><span class="n">data</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">df</span><span class="p">)</span><span class="w">
</span><span class="n">print</span><span class="p">(</span><span class="n">anova</span><span class="p">(</span><span class="n">modelo_agrupado</span><span class="p">))</span><span class="w">
</span></code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Analysis of Variance Table

Response: Resp
          Df  Sum Sq Mean Sq F value    Pr(&gt;F)    
Tempo      1  8.2689  8.2689  18.105 0.0002568 ***
Residuals 25 11.4179  0.4567                      
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
</code></pre></div></div>

<p>Os coeficientes desse ajuste são obtidos por:</p>

<div class="language-R highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">print</span><span class="p">(</span><span class="n">modelo_agrupado</span><span class="p">)</span><span class="w">
</span></code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Call:
lm(formula = Resp ~ Tempo, data = df)

Coefficients:
(Intercept)        Tempo  
    99.8896      -0.2259  
</code></pre></div></div>

<p>Ou seja, o modelo agrupado resulta na equação:</p>

\[\text{Resp} = 99{,}8896 - 0{,}2259 \times \text{Tempo}\]

<h2 id="estimando-o-tempo-de-prateleira-shelf-life">Estimando o tempo de prateleira (shelf life)</h2>

<p>Com o modelo agrupado em mãos, podemos estimar “por extrapolação” o tempo de prateleira. O <em>shelf life</em> é definido como o ponto em que o limite inferior de confiança para a reta verdadeira intercepta o limite inferior de especificação (LIE), aqui considerado como 95% do valor declarado, com 95% de confiança unilateral.</p>

<p>Esse ponto pode ser obtido resolvendo uma equação quadrática de forma exata, mas também é possível encontrá-lo numericamente, buscando o valor de tempo em que o limite inferior do intervalo de confiança cruza o LIE. Para isso, primeiro calculamos o intervalo de confiança em uma grade fina de tempos:</p>

<div class="language-R highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Novos tempos para previsão</span><span class="w">
</span><span class="n">novos_tempos</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">data.frame</span><span class="p">(</span><span class="n">Tempo</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">seq</span><span class="p">(</span><span class="m">0</span><span class="p">,</span><span class="w"> </span><span class="m">30</span><span class="p">,</span><span class="w"> </span><span class="n">length.out</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">50000</span><span class="p">))</span><span class="w">

</span><span class="c1"># Intervalo de confiança (90% bilateral = 95% unilateral)</span><span class="w">
</span><span class="n">pred</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">predict</span><span class="p">(</span><span class="n">modelo_agrupado</span><span class="p">,</span><span class="w">
                 </span><span class="n">newdata</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">novos_tempos</span><span class="p">,</span><span class="w">
                 </span><span class="n">interval</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"confidence"</span><span class="p">,</span><span class="w">
                 </span><span class="n">level</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">0.90</span><span class="p">)</span><span class="w">

</span><span class="n">print</span><span class="p">(</span><span class="n">head</span><span class="p">(</span><span class="n">pred</span><span class="p">))</span><span class="w">
</span></code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>      fit      lwr      upr
1 99.88963 99.53836 100.2409
2 99.88949 99.53827 100.2407
3 99.88936 99.53818 100.2405
4 99.88922 99.53808 100.2404
5 99.88909 99.53799 100.2402
6 99.88895 99.53790 100.2400
</code></pre></div></div>

<p>O valor “exagerado” de 50.000 pontos serve apenas para ganharmos precisão na estimativa do ponto de cruzamento. Agora identificamos o primeiro tempo em que o limite inferior do IC fica abaixo do LIE:</p>

<div class="language-R highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">LIE</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="m">95</span><span class="w">

</span><span class="n">idx</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">which</span><span class="p">(</span><span class="n">pred</span><span class="p">[,</span><span class="w"> </span><span class="s2">"lwr"</span><span class="p">]</span><span class="w"> </span><span class="o">&lt;</span><span class="w"> </span><span class="n">LIE</span><span class="p">)[</span><span class="m">1</span><span class="p">]</span><span class="w">
</span><span class="n">shelf_life</span><span class="w"> </span><span class="o">&lt;-</span><span class="w"> </span><span class="n">novos_tempos</span><span class="o">$</span><span class="n">Tempo</span><span class="p">[</span><span class="n">idx</span><span class="p">]</span><span class="w">

</span><span class="n">cat</span><span class="p">(</span><span class="n">sprintf</span><span class="p">(</span><span class="s2">"Shelf-life estimado: %.2f meses"</span><span class="p">,</span><span class="w"> </span><span class="n">shelf_life</span><span class="p">))</span><span class="w">
</span></code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Shelf-life estimado: 16.24 meses
</code></pre></div></div>

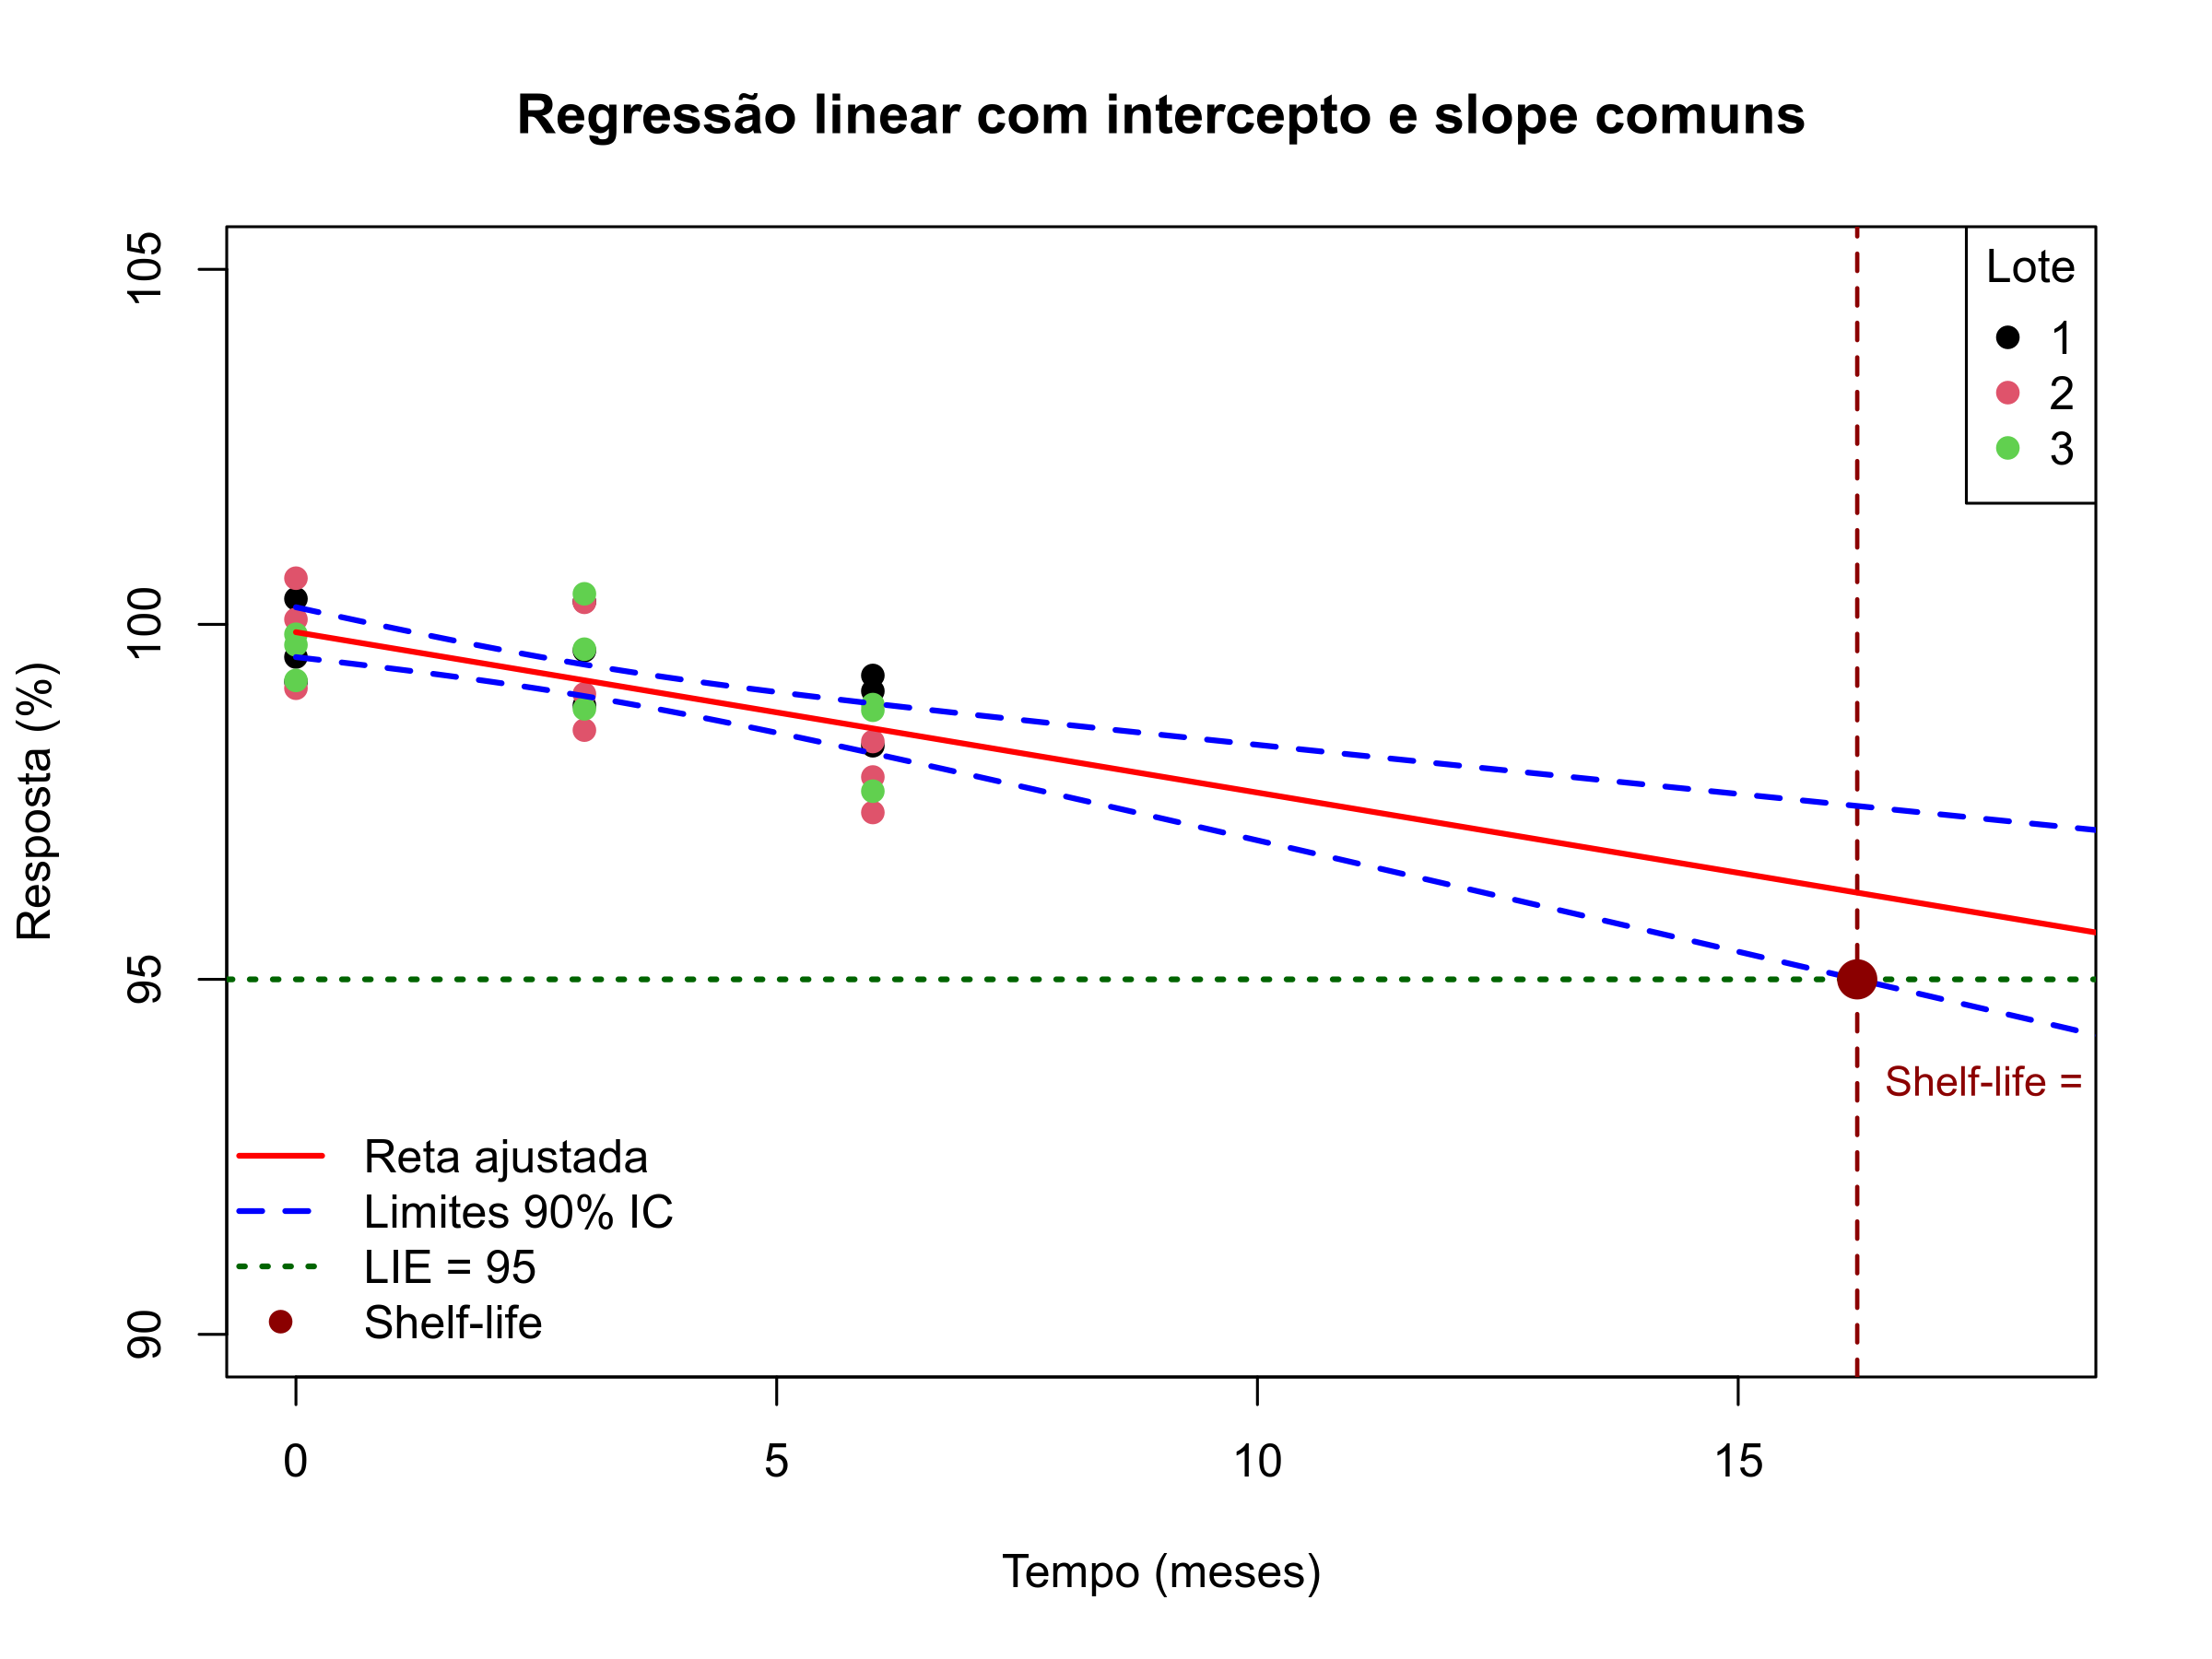
<p>O tempo de prateleira estimado é de <strong>16,24 meses</strong>. A interpretação é a de que há 95% de confiança de que a média verdadeira da resposta (equivalentemente, o percentil 50% sob normalidade) não esteja abaixo de 95% do valor declarado antes desse período.</p>

<h2 id="visualizando-os-resultados">Visualizando os resultados</h2>

<p>Por fim, podemos representar graficamente o ajuste, os limites de confiança e o ponto correspondente ao tempo de prateleira:</p>

<div class="language-R highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Gráfico base: dispersão dos dados coloridos por lote</span><span class="w">
</span><span class="n">plot</span><span class="p">(</span><span class="n">df</span><span class="o">$</span><span class="n">Tempo</span><span class="p">,</span><span class="w"> </span><span class="n">df</span><span class="o">$</span><span class="n">Resp</span><span class="p">,</span><span class="w">
     </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">as.numeric</span><span class="p">(</span><span class="n">df</span><span class="o">$</span><span class="n">Lote</span><span class="p">),</span><span class="w">
     </span><span class="n">xlab</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"Tempo (meses)"</span><span class="p">,</span><span class="w">
     </span><span class="n">ylab</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"Resposta (%)"</span><span class="p">,</span><span class="w">
     </span><span class="n">main</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"Regressão linear com intercepto e slope comuns"</span><span class="p">,</span><span class="w">
     </span><span class="n">xlim</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="m">0</span><span class="p">,</span><span class="w"> </span><span class="m">18</span><span class="p">),</span><span class="w">
     </span><span class="n">ylim</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="m">90</span><span class="p">,</span><span class="w"> </span><span class="m">105</span><span class="p">),</span><span class="w">
     </span><span class="n">pch</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">19</span><span class="p">)</span><span class="w">

</span><span class="c1"># Linha horizontal do LIE</span><span class="w">
</span><span class="n">abline</span><span class="p">(</span><span class="n">h</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">LIE</span><span class="p">,</span><span class="w"> </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"darkgreen"</span><span class="p">,</span><span class="w"> </span><span class="n">lty</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">3</span><span class="p">,</span><span class="w"> </span><span class="n">lwd</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">)</span><span class="w">

</span><span class="c1"># Linha vertical no shelf life</span><span class="w">
</span><span class="n">abline</span><span class="p">(</span><span class="n">v</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">shelf_life</span><span class="p">,</span><span class="w"> </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"darkred"</span><span class="p">,</span><span class="w"> </span><span class="n">lty</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">,</span><span class="w"> </span><span class="n">lwd</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">1.5</span><span class="p">)</span><span class="w">

</span><span class="c1"># Reta ajustada</span><span class="w">
</span><span class="n">lines</span><span class="p">(</span><span class="n">novos_tempos</span><span class="o">$</span><span class="n">Tempo</span><span class="p">,</span><span class="w"> </span><span class="n">pred</span><span class="p">[,</span><span class="w"> </span><span class="s2">"fit"</span><span class="p">],</span><span class="w"> </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"red"</span><span class="p">,</span><span class="w"> </span><span class="n">lwd</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">)</span><span class="w">

</span><span class="c1"># Limites de confiança (90% bilateral = 95% unilateral)</span><span class="w">
</span><span class="n">lines</span><span class="p">(</span><span class="n">novos_tempos</span><span class="o">$</span><span class="n">Tempo</span><span class="p">,</span><span class="w"> </span><span class="n">pred</span><span class="p">[,</span><span class="w"> </span><span class="s2">"lwr"</span><span class="p">],</span><span class="w"> </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"blue"</span><span class="p">,</span><span class="w"> </span><span class="n">lty</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">,</span><span class="w"> </span><span class="n">lwd</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">)</span><span class="w">
</span><span class="n">lines</span><span class="p">(</span><span class="n">novos_tempos</span><span class="o">$</span><span class="n">Tempo</span><span class="p">,</span><span class="w"> </span><span class="n">pred</span><span class="p">[,</span><span class="w"> </span><span class="s2">"upr"</span><span class="p">],</span><span class="w"> </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"blue"</span><span class="p">,</span><span class="w"> </span><span class="n">lty</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">,</span><span class="w"> </span><span class="n">lwd</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">2</span><span class="p">)</span><span class="w">

</span><span class="c1"># Ponto de interseção (shelf life)</span><span class="w">
</span><span class="n">points</span><span class="p">(</span><span class="n">shelf_life</span><span class="p">,</span><span class="w"> </span><span class="n">LIE</span><span class="p">,</span><span class="w"> </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"darkred"</span><span class="p">,</span><span class="w"> </span><span class="n">pch</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">19</span><span class="p">,</span><span class="w"> </span><span class="n">cex</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">1.8</span><span class="p">)</span><span class="w">

</span><span class="c1"># Anotação com o valor do shelf life</span><span class="w">
</span><span class="n">text</span><span class="p">(</span><span class="n">shelf_life</span><span class="p">,</span><span class="w"> </span><span class="n">LIE</span><span class="w"> </span><span class="o">-</span><span class="w"> </span><span class="m">1.5</span><span class="p">,</span><span class="w">
     </span><span class="n">labels</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">paste0</span><span class="p">(</span><span class="s2">"Shelf-life = "</span><span class="p">,</span><span class="w"> </span><span class="nf">round</span><span class="p">(</span><span class="n">shelf_life</span><span class="p">,</span><span class="w"> </span><span class="m">2</span><span class="p">),</span><span class="w"> </span><span class="s2">" meses"</span><span class="p">),</span><span class="w">
     </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"darkred"</span><span class="p">,</span><span class="w"> </span><span class="n">cex</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">0.9</span><span class="p">,</span><span class="w"> </span><span class="n">pos</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">4</span><span class="p">)</span><span class="w">

</span><span class="c1"># Legenda dos lotes</span><span class="w">
</span><span class="n">legend</span><span class="p">(</span><span class="s2">"topright"</span><span class="p">,</span><span class="w">
       </span><span class="n">legend</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="n">levels</span><span class="p">(</span><span class="n">df</span><span class="o">$</span><span class="n">Lote</span><span class="p">),</span><span class="w">
       </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">1</span><span class="o">:</span><span class="nf">length</span><span class="p">(</span><span class="n">levels</span><span class="p">(</span><span class="n">df</span><span class="o">$</span><span class="n">Lote</span><span class="p">)),</span><span class="w">
       </span><span class="n">pch</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="m">19</span><span class="p">,</span><span class="w">
       </span><span class="n">title</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"Lote"</span><span class="p">)</span><span class="w">

</span><span class="c1"># Legenda das curvas e do shelf life</span><span class="w">
</span><span class="n">legend</span><span class="p">(</span><span class="s2">"bottomleft"</span><span class="p">,</span><span class="w">
       </span><span class="n">legend</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="s2">"Reta ajustada"</span><span class="p">,</span><span class="w"> </span><span class="s2">"Limites 90% IC"</span><span class="p">,</span><span class="w">
                  </span><span class="s2">"LIE = 95"</span><span class="p">,</span><span class="w"> </span><span class="s2">"Shelf-life"</span><span class="p">),</span><span class="w">
       </span><span class="n">col</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="s2">"red"</span><span class="p">,</span><span class="w"> </span><span class="s2">"blue"</span><span class="p">,</span><span class="w"> </span><span class="s2">"darkgreen"</span><span class="p">,</span><span class="w"> </span><span class="s2">"darkred"</span><span class="p">),</span><span class="w">
       </span><span class="n">lty</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="m">1</span><span class="p">,</span><span class="w"> </span><span class="m">2</span><span class="p">,</span><span class="w"> </span><span class="m">3</span><span class="p">,</span><span class="w"> </span><span class="kc">NA</span><span class="p">),</span><span class="w">
       </span><span class="n">pch</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="kc">NA</span><span class="p">,</span><span class="w"> </span><span class="kc">NA</span><span class="p">,</span><span class="w"> </span><span class="kc">NA</span><span class="p">,</span><span class="w"> </span><span class="m">19</span><span class="p">),</span><span class="w">
       </span><span class="n">lwd</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="nf">c</span><span class="p">(</span><span class="m">2</span><span class="p">,</span><span class="w"> </span><span class="m">2</span><span class="p">,</span><span class="w"> </span><span class="m">2</span><span class="p">,</span><span class="w"> </span><span class="kc">NA</span><span class="p">),</span><span class="w">
       </span><span class="n">bty</span><span class="w"> </span><span class="o">=</span><span class="w"> </span><span class="s2">"n"</span><span class="p">)</span><span class="w">
</span></code></pre></div></div>

<p><img src="/images/shelf_life_plot.png" alt="Gráfico do shelf life" /></p>

<h2 id="conclusão">Conclusão</h2>

<p>Seguindo a abordagem hierárquica recomendada pelo ICH Topic Q 1 E, testamos primeiro a homogeneidade das inclinações entre lotes e, em seguida, a homogeneidade dos interceptos, usando o nível de significância de 0,25 sugerido pela guideline. Como nenhum dos dois testes indicou diferença significativa, os três lotes puderam ser agrupados em um único modelo de regressão, o que resultou em uma estimativa de tempo de prateleira de 16,24 meses, mais robusta do que estimativas obtidas lote a lote separadamente, por aproveitar toda a informação disponível no estudo.</p>

<p><br /></p>
<blockquote>
  <p><strong>Gostou do artigo? <span style="color:#c0392b">Gostaria de ver os outros casos?</span></strong></p>

  <p>Curta ou compartilhe sua opinião na publicação. 
Conecte-se no LinkedIn para acompanhar novas publicações 
sobre desenvolvimento analítico, estatística e ferramentas 
computacionais aplicadas à indústria farmacêutica.</p>
</blockquote>

<p><br /></p>
<blockquote>
  <p><strong>Continue explorando</strong></p>

  <p><a href="/">Ver outros posts</a></p>
</blockquote>]]></content><author><name></name></author><summary type="html"><![CDATA[O ICH Topic Q 1 E (Evaluation of Stability Data) apresenta o trecho abaixo, que descreve o procedimento estatístico recomendado para decidir se os dados de diferentes lotes podem ser agrupados em uma análise de estabilidade:]]></summary></entry><entry><title type="html">Precisão no preparo de soluções</title><link href="/2026/07/16/precisao-solucoes.html" rel="alternate" type="text/html" title="Precisão no preparo de soluções" /><published>2026-07-16T19:39:00+00:00</published><updated>2026-07-16T19:39:00+00:00</updated><id>/2026/07/16/precisao-solucoes</id><content type="html" xml:base="/2026/07/16/precisao-solucoes.html"><![CDATA[<p><img src="/images/precisao_sol.png" alt="Figura" /></p>

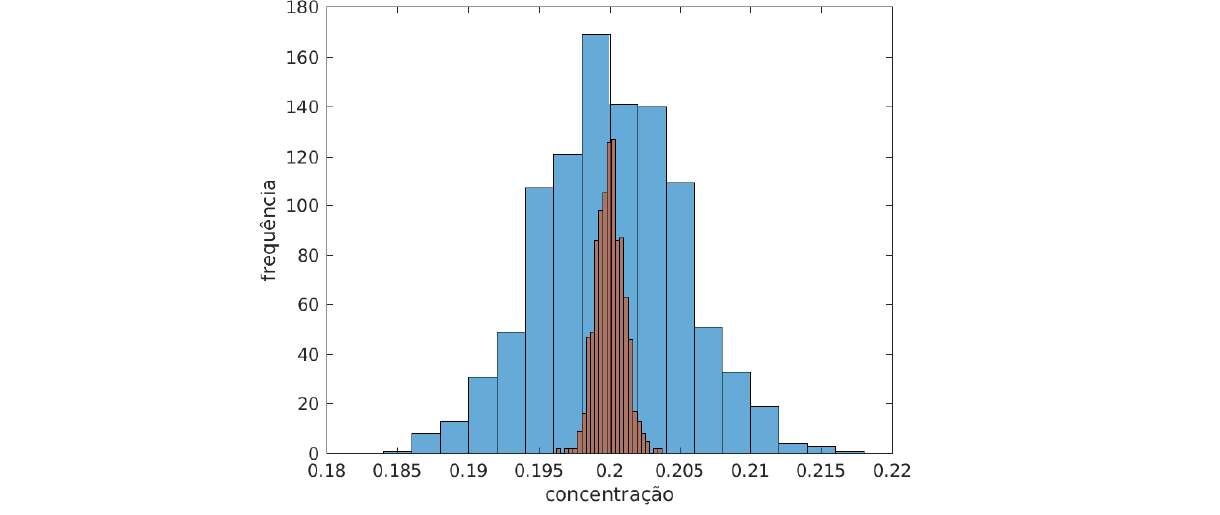
<p>Imagine que tenhamos que preparar um padrão de calibração com concentração aproximada de 0,200 mg/mL. Podemos destacar dois preparos possíveis:</p>

<ol>
  <li>Pesar 4,00 mg e diluir em balão de 20 mL (C = 0,200 mg/mL);</li>
  <li>Pesar 20,00 mg e diluir em balão de 100 mL (C = 0,200 mg/mL).</li>
</ol>

<p>A partir da massa pesada e do volume do balão calcula-se a concentração experimental.</p>

<p><strong><em>Pergunta-se: em qual preparo, 1 ou 2, a concentração experimental terá maior probabilidade de estar mais próxima da concentração real (desconhecida)?</em></strong></p>

<p>Espere! Eu sei que alguns dirão que, ao se pesar uma massa maior, o erro da pesagem tende a ser menor. Então, para isolarmos outro efeito, vamos considerar que o erro absoluto cometido pela balança permaneça o mesmo, tanto para a pesagem de 4,00 mg quanto para a de 20,00 mg.</p>

<p>Além disso, para simplificar a discussão, vamos desprezar o erro do volume dos balões.</p>

<p>Estou fazendo isso para verificarmos, de maneira cuidadosa, a origem da maior precisão em algum preparo, se é que ela existe. Também estou sendo otimista em relação ao desempenho da balança.</p>

<h3 id="discussão">Discussão</h3>

<p>Vamos atacar o problema agora.</p>

<p>A massa experimental, $m_{exp}$, determinada na pesagem, é a massa real desconhecida, $m_{real}$, acrescida de um erro de pesagem, $\varepsilon$, que pode ser positivo ou negativo.</p>

<p>\begin{equation}
m_{exp} = m_{real} + \varepsilon
\end{equation}</p>

<hr />
<p><br /></p>

<p>No <strong><em>caso 1</em></strong>, a concentração experimental, $C_{exp}$, será dada por,</p>

<p>\begin{equation}
C_{exp} =
\frac{m_{exp}}{20\,\mathrm{mL}} =
\frac{m_{real}+\varepsilon}{20\,\mathrm{mL}} =
\frac{m_{real}}{20\,\mathrm{mL}} +
\frac{\varepsilon}{20\,\mathrm{mL}}
\end{equation}</p>

<p>Note que $\frac{m_{real}}{20\,\mathrm{mL}}$ é a concentração real, $C_{real}$. Assim,</p>

<p>\begin{equation}
C_{exp} = C_{real} + \frac{\varepsilon}{20\,\mathrm{mL}}.
\end{equation}</p>

<p>Portanto, a diferença entre a concentração experimental e a concentração real é dada por</p>

<p>\begin{equation}
C_{exp}-C_{real}=\frac{\varepsilon}{20\,\mathrm{mL}}.
\end{equation}</p>

<hr />
<p><br /></p>

<p>No <strong><em>caso 2</em></strong>, a concentração experimental, $C_{exp}$, será dada por,</p>

<p>\begin{equation}
C_{exp} = 
\frac{m_{exp}}{100\,\mathrm{mL}} = 
\frac{m_{real} + \varepsilon}{100\,\mathrm{mL}} = 
\frac{m_{real}}{100\,\mathrm{mL}} + 
\frac{\varepsilon}{100\,\mathrm{mL}}
\end{equation}</p>

<p>Note que $\frac{m_{real}}{100\,\mathrm{mL}}$ é a concentração real, $C_{real}$. Assim,</p>

<p>\begin{equation}
C_{exp} = C_{real} + \frac{\varepsilon}{100\,\mathrm{mL}}.
\end{equation}</p>

<p>Portanto, a diferença entre a concentração experimental e a concentração real é dada por</p>

<p>\begin{equation}
C_{exp}-C_{real}=\frac{\varepsilon}{100\,\mathrm{mL}}.
\end{equation}</p>

<hr />
<p><br /></p>

<h3 id="conclusão">Conclusão</h3>

<p>Como</p>

<p>\begin{equation}
\frac{|\varepsilon|}{100\,\mathrm{mL}}
&lt;
\frac{|\varepsilon|}{20\,\mathrm{mL}},
\end{equation}</p>

<p>o segundo preparo tende a produzir uma concentração experimental mais próxima da concentração real.</p>

<p>Em outras palavras, mantendo-se o mesmo erro absoluto da pesagem, aumentar o volume final reduz a influência desse erro sobre a concentração obtida.</p>

<h3 id="ressalvas">Ressalvas</h3>

<p>O exemplo apresentado é meramente hipotético e teve como objetivo isolar o efeito do erro da pesagem.</p>

<p>Na prática, o volume do balão também possui uma tolerância, além de existirem outras fontes de erro. Ainda assim, o raciocínio mostra que uma das causas da maior precisão observada em preparos de maior volume é que o erro absoluto da pesagem é dividido por um volume maior.</p>

<p>O exemplo também mostra a tendência de se reduzir a precisão ao se miniaturizar preparos (mantendo-se as proporções). Esse aspecto deve ser considerado sempre que se opta por preparos em menor escala.</p>

<p><br /></p>
<blockquote>
  <p><strong>Gostou do artigo?</strong></p>

  <p>Curta ou compartilhe sua opinião na publicação. 
Conecte-se no LinkedIn para acompanhar novas publicações 
sobre desenvolvimento analítico, estatística e ferramentas 
computacionais aplicadas à indústria farmacêutica.</p>
</blockquote>

<p><br /></p>
<blockquote>
  <p><strong>Continue explorando</strong></p>

  <p><a href="/">Ver outros posts</a></p>
</blockquote>]]></content><author><name></name></author><summary type="html"><![CDATA[]]></summary></entry><entry><title type="html">Resolução Analítica da Isoterma de Langmuir no Contexto de Aplicações Farmacêuticas</title><link href="/2026/07/13/colestiramina.html" rel="alternate" type="text/html" title="Resolução Analítica da Isoterma de Langmuir no Contexto de Aplicações Farmacêuticas" /><published>2026-07-13T21:07:00+00:00</published><updated>2026-07-13T21:07:00+00:00</updated><id>/2026/07/13/colestiramina</id><content type="html" xml:base="/2026/07/13/colestiramina.html"><![CDATA[<p>Alguns fármacos, como a colestiramina, utilizada 
no tratamento da hipercolesterolemia, possuem sua ação baseada em mecanismos de adsorção, geralmente descrito pela equação de Langmuir.</p>

<p>Nesse sentido, os ensaios de doseamento são geralmente baseados na quantidade de analito adsorvida, portanto o ensaio geralmente não segue a forma padrão de quantificação de fármacos convencionais, isto é, baseada na proporcionalidade de um sinal analítico.</p>

<p>Nesse post, vou explorar a equação de Langmuir. O entendimento dos ensaios de <strong>doseamento</strong>, <strong>ação</strong>, e estudos de <strong>bioequivalência</strong> passam necessariamente pela compreensão desse mecanismo de adsorção descrito por essa equação.</p>

<h3 id="o-experimento">O experimento</h3>

<p>No experimento, utiliza-se uma quantidade fixa de adsorvente, adiciona-se uma quantidade de solução com concentração de analito conhecida $C_0$. Após algum processo, que pode incluir agitação, adequação de temperatura e tempo de equilíbrio, o material adsorve parte do analito presente na solução inicial, e a concentração da solução diminui. A concentração medida ao final dessa etapa é a concentração de equilíbrio, $C_{eq}$.</p>

<p>E a quantidade adsorvida por unidade de material $q$ é dada por:</p>

<p>\begin{equation}
q = \frac{n_{ads}}{m}
\end{equation}
em que $n_{ads}$ é a quantidade de analito adsorvida e $m$ é a massa.</p>

<p>A quantidade adsorvida $q$ depende da concentração inicial $C_0$, portanto para $C_0$ diferentes existirá concentrações de equilíbrio $C_{eq}$ diferentes.</p>

<h3 id="equação-de-langmuir">Equação de Langmuir</h3>

<p>A equação de Langmuir relaciona $q$ a $C_{eq}$ por um caminho não linear, descrito abaixo:
\begin{equation}
q=\frac{k_1k_2C_{eq}}{1+k_1C_{eq}}
\end{equation}
em que,</p>
<ul>
  <li>$k_1$ é a constante de afinidade;</li>
  <li>$k_2$ é a constante de capacidade (corresponde à capacidade máxima de adsorção).</li>
</ul>

<p><strong>Conhecendo-se $k_1$ e $k_2$ é possível prever a quantidade adsorvida $q$ e a concentração de equilíbrio $C_{eq}$,</strong> para dado $C_0$ experimental. Mas como resolver esse problema?</p>

<h3 id="resolvendo-o-equilíbrio-de-langmuir">Resolvendo o equilíbrio de Langmuir</h3>

<p>Nessa seção, vamos resolver exatamente o problema: <strong>encontrar $q$ e $C_{eq}$</strong> como função de $C_0$.</p>

<p>Encontramos $n_{ads}$ isolando-o na expressão para o balanço de quantidade material $n_0 = n_{ads}+n_{eq}$ em que $n_0$ é a quantidade de analito inicial e $n_{eq}$ é a quantidade de analito livre no equilíbrio. Portanto, $n_{ads} = n_0 - n_{eq}$ ou pela divisão por $V$, encontra-se 
$C_{ads} = \frac{n_{ads}}{V} = C_0 - C_{eq}$. Assim, $n_{ads} = C_{ads}\times V$ com $C_{ads} = C_0 - C_{eq}$.</p>

<p>Portanto, podemos escrever a Equação (1) como,
\begin{equation}
q = \frac{(C_0 - C_{eq})\times V}{m}\,.
\end{equation}
Ou definindo $\alpha = V/m$
\begin{equation}
q = (C_0 - C_{eq})\times \alpha
\end{equation}</p>

<p>Substituindo a Equação acima na Equação (2), obtém-se
\begin{equation}
(C_0 - C_{eq})\times \alpha = \frac{k_1k_2C_{eq}}{1+k_1C_{eq}}
\end{equation}
ou
\begin{equation}
(C_0 - C_{eq})\times \alpha\times(1+k_1C_{eq})=k_1k_2C_{eq}
\end{equation}</p>

<p>Expandindo o lado esquerdo,</p>

<p>\begin{equation}
\alpha C_0
+\alpha k_1C_0C_{eq}
-\alpha C_{eq}
-\alpha k_1C_{eq}^2
=
k_1k_2C_{eq}.
\end{equation}</p>

<p>Reorganizando todos os termos em um único membro,</p>

<p>\begin{equation}
\alpha k_1C_{eq}^2
+
(\alpha+k_1k_2-\alpha k_1C_0)C_{eq}
-
\alpha C_0
=
0.
\end{equation}</p>

<p>A Equação acima possui a forma geral
\begin{equation}
aC_{eq}^2+bC_{eq}+c=0,
\end{equation}
com coeficientes</p>

\[\begin{align}
a &amp;= \alpha k_1,\\
b &amp;= \alpha+k_1k_2-\alpha k_1C_0,\\
c &amp;= -\alpha C_0.
\end{align}\]

<p><strong>Isto mesmo, para resolver o problema basta resolver uma equação de segundo grau!</strong></p>

<p>A concentração no equilíbrio é encontrada resolvendo-se a equação do segundo grau por</p>

<p>\begin{equation}
C_{eq}
=
\frac{-b+\sqrt{b^2-4ac}}
{2a}.
\end{equation}</p>

<p>Finalmente, a quantidade adsorvida é obtida substituindo a concentração de equilíbrio na Equação (4), (repetida abaixo),
\begin{equation}
    q = (C_0 - C_{eq})\times \alpha
\end{equation}
e a quantidade total adsorvida é dada por
\begin{equation}
    n_{ads} = (C_0-C_{eq})V.
\end{equation}</p>

<h3 id="solução-computacional">Solução computacional</h3>

<p>Podemos resolver o problema agora, utilizando alguma linguagem de programação, neste caso Python.</p>

<p>Uma boa estratégia e definir uma função, como abaixo:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>

<span class="k">def</span> <span class="nf">langmuir_q</span><span class="p">(</span><span class="n">C0</span><span class="p">,</span> <span class="n">k1</span><span class="p">,</span> <span class="n">k2</span><span class="p">,</span> <span class="n">V</span><span class="p">,</span> <span class="n">m</span><span class="p">):</span>
    <span class="sh">"""</span><span class="s">
    Calcula q a partir da concentração inicial C0.

    Parâmetros
    ----------
    C0 : concentração inicial (mM)
    k1 : constante de afinidade
    k2 : constante de capacidade
    V  : volume da solução (L)
    m  : massa do adsorvente (g)

    Retorna
    -------
    Ceq : concentração de equilíbrio (mM)
    q   : quantidade adsorvida (mM/g)
    </span><span class="sh">"""</span>

    <span class="n">alpha</span> <span class="o">=</span> <span class="n">V</span> <span class="o">/</span> <span class="n">m</span>

    <span class="n">a</span> <span class="o">=</span> <span class="n">alpha</span> <span class="o">*</span> <span class="n">k1</span>
    <span class="n">b</span> <span class="o">=</span> <span class="n">alpha</span> <span class="o">+</span> <span class="n">k1</span> <span class="o">*</span> <span class="n">k2</span> <span class="o">-</span> <span class="n">alpha</span> <span class="o">*</span> <span class="n">k1</span> <span class="o">*</span> <span class="n">C0</span>
    <span class="n">c</span> <span class="o">=</span> <span class="o">-</span><span class="n">alpha</span> <span class="o">*</span> <span class="n">C0</span>

    <span class="n">delta</span> <span class="o">=</span> <span class="n">b</span><span class="o">**</span><span class="mi">2</span> <span class="o">-</span> <span class="mi">4</span><span class="o">*</span><span class="n">a</span><span class="o">*</span><span class="n">c</span>

    <span class="c1"># raiz física
</span>    <span class="n">Ceq</span> <span class="o">=</span> <span class="p">(</span><span class="o">-</span><span class="n">b</span> <span class="o">+</span> <span class="n">np</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">delta</span><span class="p">))</span> <span class="o">/</span> <span class="p">(</span><span class="mi">2</span><span class="o">*</span><span class="n">a</span><span class="p">)</span>

    <span class="n">q</span> <span class="o">=</span> <span class="n">alpha</span> <span class="o">*</span> <span class="p">(</span><span class="n">C0</span> <span class="o">-</span> <span class="n">Ceq</span><span class="p">)</span>

    <span class="n">n_FL</span> <span class="o">=</span> <span class="p">(</span><span class="n">C0</span><span class="o">-</span><span class="n">Ceq</span><span class="p">)</span><span class="o">*</span><span class="n">V</span>

    <span class="k">return</span> <span class="n">Ceq</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">n_FL</span>
</code></pre></div></div>

<p>Agora só utilizar a função para uma faixa de concentrações iniciais e parâmetros desejados, por exemplo:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">k1</span> <span class="o">=</span> <span class="mf">0.891</span><span class="o">/</span><span class="mf">1e-4</span>    <span class="c1"># constante de afinidade (L/mol) [Glycocholate]
</span><span class="n">k2</span> <span class="o">=</span> <span class="mf">0.863</span><span class="o">/</span><span class="mi">230</span>     <span class="c1"># capacidade máxima de adsorção (mol/g) [Glycocholate]
</span><span class="n">V</span> <span class="o">=</span> <span class="mf">0.025</span>          <span class="c1"># L
</span><span class="n">m</span> <span class="o">=</span> <span class="mf">0.025</span>          <span class="c1"># g
</span>
<span class="c1"># Concentrações iniciais, mol/L
</span><span class="n">C0</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">array</span><span class="p">([</span><span class="mf">1.0</span><span class="p">,</span> <span class="mf">1.7</span><span class="p">,</span> <span class="mf">2.3</span><span class="p">,</span> <span class="mf">2.6</span><span class="p">,</span> <span class="mf">3.2</span><span class="p">,</span> <span class="mf">3.6</span><span class="p">,</span> <span class="mi">4</span><span class="p">])</span><span class="o">*</span><span class="mf">1e-3</span>

<span class="c1"># Resolvendo o equilibrio
</span><span class="n">Ceq</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">n_FL</span> <span class="o">=</span> <span class="nf">langmuir_q</span><span class="p">(</span><span class="n">C0</span><span class="p">,</span> <span class="n">k1</span><span class="p">,</span> <span class="n">k2</span><span class="p">,</span> <span class="n">V</span><span class="p">,</span> <span class="n">m</span><span class="p">)</span>
</code></pre></div></div>

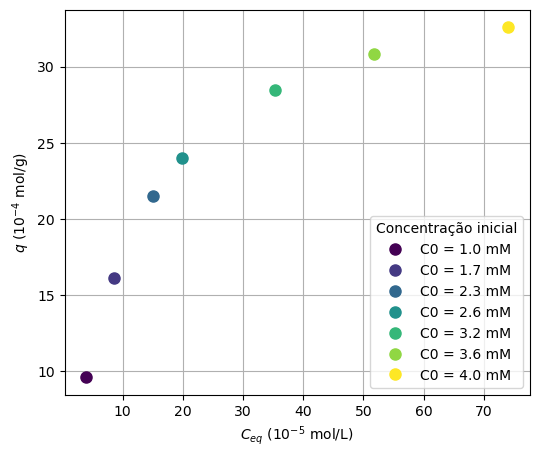
<p>Por fim podemos fazer um gráfico.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>

<span class="c1"># Mapa de cores
</span><span class="n">cores</span> <span class="o">=</span> <span class="n">plt</span><span class="p">.</span><span class="n">cm</span><span class="p">.</span><span class="nf">viridis</span><span class="p">(</span><span class="n">np</span><span class="p">.</span><span class="nf">linspace</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">C0</span><span class="p">)))</span>

<span class="n">plt</span><span class="p">.</span><span class="nf">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">6</span><span class="p">,</span> <span class="mi">5</span><span class="p">))</span>

<span class="k">for</span> <span class="n">c0</span><span class="p">,</span> <span class="n">ceq</span><span class="p">,</span> <span class="n">qi</span><span class="p">,</span> <span class="n">cor</span> <span class="ow">in</span> <span class="nf">zip</span><span class="p">(</span><span class="n">C0</span><span class="p">,</span> <span class="n">Ceq</span><span class="p">,</span> <span class="n">q</span><span class="p">,</span> <span class="n">cores</span><span class="p">):</span>
    <span class="n">plt</span><span class="p">.</span><span class="nf">plot</span><span class="p">(</span>
        <span class="n">ceq</span><span class="o">*</span><span class="mf">1e5</span><span class="p">,</span>
        <span class="n">qi</span><span class="o">*</span><span class="mf">1e4</span><span class="p">,</span>
             <span class="sh">'</span><span class="s">o</span><span class="sh">'</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="n">cor</span><span class="p">,</span> <span class="n">markersize</span><span class="o">=</span><span class="mi">8</span><span class="p">,</span>
             <span class="n">label</span><span class="o">=</span><span class="sa">f</span><span class="sh">"</span><span class="s">C0 = </span><span class="si">{</span><span class="n">c0</span><span class="o">*</span><span class="mi">1000</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s"> mM</span><span class="sh">"</span>
             <span class="p">)</span>

<span class="n">plt</span><span class="p">.</span><span class="nf">xlabel</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">$C_{eq}$ ($10^{-5}$ mol/L)</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">ylabel</span><span class="p">(</span><span class="sa">r</span><span class="sh">"</span><span class="s">$q$ ($10^{-4}$ mol/g)</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">legend</span><span class="p">(</span><span class="n">title</span><span class="o">=</span><span class="sh">"</span><span class="s">Concentração inicial</span><span class="sh">"</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="nf">grid</span><span class="p">(</span><span class="bp">True</span><span class="p">)</span>
</code></pre></div></div>

<p><img src="/images/post_colestiramina_6_0.png" alt="png" /></p>

<p><br /></p>
<blockquote>
  <p><strong>Gostou do artigo?</strong></p>

  <p>Curta ou compartilhe sua opinião na publicação. 
Conecte-se no LinkedIn para acompanhar novas publicações 
sobre desenvolvimento analítico, estatística e ferramentas 
computacionais aplicadas à indústria farmacêutica.</p>
</blockquote>

<p><br /></p>
<blockquote>
  <p><strong>Continue explorando</strong></p>

  <p><a href="/">Ver outros posts</a></p>
</blockquote>]]></content><author><name></name></author><summary type="html"><![CDATA[Alguns fármacos, como a colestiramina, utilizada no tratamento da hipercolesterolemia, possuem sua ação baseada em mecanismos de adsorção, geralmente descrito pela equação de Langmuir.]]></summary></entry><entry><title type="html">Avaliação da precisão repetibilidade</title><link href="/2026/07/12/precisao-repe.html" rel="alternate" type="text/html" title="Avaliação da precisão repetibilidade" /><published>2026-07-12T17:49:00+00:00</published><updated>2026-07-12T17:49:00+00:00</updated><id>/2026/07/12/precisao-repe</id><content type="html" xml:base="/2026/07/12/precisao-repe.html"><![CDATA[<p>A precisão de um procedimento analítico expressa a proximidade de concordância (grau de dispersão) entre uma série de medições obtidas a partir de múltiplas amostragens de uma mesma amostra homogênea sob as condições prescritas. A precisão pode ser considerada em três níveis: repetibilidade, precisão intermediária e reprodutibilidade [ICHQ2(R2)].</p>

<p>A precisão de um procedimento analítico é geralmente expressa como a variância,
\begin{equation}
s^2 = \frac{\sum_{i=1}^n(x_i - \bar{x})^2}{n-1}
\end{equation}
o desvio-padrão
\begin{equation}
s = \sqrt{\frac{\sum_{i=1}^n(x_i - \bar{x})^2}{n-1}}
\end{equation}
ou o coeficiente de variação
\begin{equation}
CV = 100\times\frac{s}{\bar{x}}
\end{equation}
de uma série de medições [ICHQ2(R2)].
Onde a média é dada por:
\begin{equation}
\bar{x} = \frac{\sum_{i=1}^n x_i}{n}
\end{equation}</p>

<h2 id="avaliação-da-precisão-repetibilidade">Avaliação da Precisão Repetibilidade</h2>

<h3 id="estimativa-pontual">Estimativa pontual</h3>

<p>Calculado por meio de estimativa pontual (variância, desvio-padrão ou o coeficiente de variação). A avaliação é feita por meio da comparação direta dos resultados de precisão com algum critério pré-definido.</p>

<p><strong>Vantagens</strong></p>

<ul>
  <li>Prático e fácil de entender;</li>
  <li>Matemática simples.</li>
</ul>

<p><strong>Desvantagens</strong></p>

<ul>
  <li>Não possui um controle numérico definido do risco;</li>
  <li>Não considera a variabilidade das estimativas.</li>
</ul>

<p><strong>Exemplo</strong></p>

<p>No exemplo abaixo (em Python) são apresentados resultados “hipotéticos” de avaliação de teor como um percentual em relação ao valor declarado. Neste caso foram consideradas 6 (seis) réplicas a 100% (cem por cento) da concentração do teste individualmente preparadas [RDC166].</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">pandas</span> <span class="k">as</span> <span class="n">pd</span>

<span class="c1"># Percentuais em relação ao valor declarado
</span><span class="n">respostas</span> <span class="o">=</span> <span class="p">[</span><span class="mf">101.8</span><span class="p">,</span> <span class="mf">102.1</span><span class="p">,</span> <span class="mf">101.9</span><span class="p">,</span> <span class="mf">103.2</span><span class="p">,</span> <span class="mf">102.5</span><span class="p">,</span> <span class="mf">101.8</span><span class="p">]</span>
<span class="n">df</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="nc">DataFrame</span><span class="p">({</span><span class="sh">"</span><span class="s">Resposta</span><span class="sh">"</span><span class="p">:</span> <span class="n">respostas</span><span class="p">})</span>

<span class="nf">print</span><span class="p">(</span><span class="n">df</span><span class="p">)</span>
</code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>   Resposta
0     101.8
1     102.1
2     101.9
3     103.2
4     102.5
5     101.8
</code></pre></div></div>

<p>O desvio-padrão e o coeficiente de variação podem ser prontamente calculados, como abaixo:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">xbar</span> <span class="o">=</span> <span class="n">df</span><span class="p">[</span><span class="sh">"</span><span class="s">Resposta</span><span class="sh">"</span><span class="p">].</span><span class="nf">mean</span><span class="p">()</span>    <span class="c1"># média
</span><span class="n">s</span> <span class="o">=</span> <span class="n">df</span><span class="p">[</span><span class="sh">"</span><span class="s">Resposta</span><span class="sh">"</span><span class="p">].</span><span class="nf">std</span><span class="p">(</span><span class="n">ddof</span><span class="o">=</span><span class="mi">1</span><span class="p">)</span>  <span class="c1"># desvio padrão amostral
</span><span class="n">CV</span> <span class="o">=</span> <span class="mi">100</span> <span class="o">*</span> <span class="n">s</span> <span class="o">/</span> <span class="n">xbar</span>             <span class="c1"># coeficiente de variação
</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">=== Resultados ===</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Média                  : </span><span class="si">{</span><span class="n">xbar</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">%</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Desvio-padrão          : </span><span class="si">{</span><span class="n">s</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">%</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Coeficiente de variação: </span><span class="si">{</span><span class="n">CV</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">%</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>=== Resultados ===
Média                  : 102.2%
Desvio-padrão          : 0.5%
Coeficiente de variação: 0.5%
</code></pre></div></div>

<p>Se o critério de aceitação for $CV\leq2\%$, o resultado obtido atende ao requisito de precisão estabelecido.</p>

<h3 id="abordagem-pelo-limite-superior-de-confiança">Abordagem pelo limite superior de confiança</h3>

<p>É calculado o limite superior de confiança que contém o parâmetro verdadeiro com um determinado nível de confiança.
A avaliação é feita comparando-se o limite superior de confiança com um critério para o parâmetro avaliado (verdadeiro) [USP1210].</p>

<p>Para o desvio padrão, um limite superior de confiança de $100(1 - \alpha)\%$ para $\sigma$ é dado por:</p>

<p>\begin{equation}
LS_\sigma = s \sqrt{\frac{n - 1}{\chi^2_{\alpha;\,n-1}}}
\end{equation}
em que:</p>

<ul>
  <li>$LS_\sigma$: limite superior de confiança de $100(1 - \alpha)\%$ para $\sigma$;</li>
  <li>$s$: desvio padrão amostral;</li>
  <li>$n$: número de resultados reportáveis;</li>
  <li>$\chi^2_{\alpha;\,n-1}$: quantil da distribuição qui-quadrado com área $\alpha$ à esquerda e $(n - 1)$ graus de liberdade.</li>
</ul>

<p><strong>Vantagens</strong></p>

<ul>
  <li>Controle numérico definido do risco;</li>
  <li>Considera a variabilidade das estimativas;</li>
  <li>Vanguarda (USP 1210, ICH Q2(R2) / Q14 Training Module).</li>
</ul>

<p><strong>Desvantagens</strong></p>

<ul>
  <li>Matemática “um pouco” mais complexa;</li>
  <li>Pode necessitar de um maior tamanho amostral.</li>
</ul>

<p>Uma aproximação do limite superior do intervalo de confiança para o coeficiente de variação consiste em tomar o limite superior do intervalo de confiança do desvio padrão e simplesmente dividi-lo pela média [ICHtrain3].</p>

<p>\begin{equation}
LS_{CV} = 100\times\frac{LS_{\sigma}}{\bar{x}}
\end{equation}</p>

<p><strong>Exemplo (continuação)</strong></p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="kn">from</span> <span class="n">scipy</span> <span class="kn">import</span> <span class="n">stats</span>

<span class="n">alpha</span> <span class="o">=</span> <span class="mf">0.05</span>
<span class="n">n</span> <span class="o">=</span> <span class="n">df</span><span class="p">.</span><span class="n">shape</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> 
<span class="n">chi2_crit</span> <span class="o">=</span> <span class="n">stats</span><span class="p">.</span><span class="n">chi2</span><span class="p">.</span><span class="nf">ppf</span><span class="p">(</span><span class="n">alpha</span><span class="p">,</span> <span class="n">df</span><span class="o">=</span><span class="n">n</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span>
<span class="n">LS_sigma</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">((</span><span class="n">n</span><span class="o">-</span><span class="mi">1</span><span class="p">)</span> <span class="o">*</span> <span class="n">s</span><span class="o">**</span><span class="mi">2</span> <span class="o">/</span> <span class="n">chi2_crit</span><span class="p">)</span>

<span class="n">LS_CV</span> <span class="o">=</span> <span class="mi">100</span><span class="o">*</span><span class="n">LS_sigma</span><span class="o">/</span><span class="n">xbar</span>

<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">=== Resultados ===</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Desvio-padrão                   : </span><span class="si">{</span><span class="n">s</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">%</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Limite superior (95%) para sigma: </span><span class="si">{</span><span class="n">LS_sigma</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">%</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">CV (estimativa)                 : </span><span class="si">{</span><span class="n">CV</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">%</span><span class="sh">"</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="s">Limite superior (95%) para CV   : </span><span class="si">{</span><span class="n">LS_CV</span><span class="si">:</span><span class="p">.</span><span class="mi">1</span><span class="n">f</span><span class="si">}</span><span class="s">%</span><span class="sh">"</span><span class="p">)</span>
</code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>=== Resultados ===
Desvio-padrão                   : 0.5%
Limite superior (95%) para sigma: 1.1%
CV (estimativa)                 : 0.5%
Limite superior (95%) para CV   : 1.1%
</code></pre></div></div>

<p>Se o critério de aceitação for $LS_{CV}\leq2\%$, o resultado obtido atende ao requisito de precisão estabelecido.</p>

<h3 id="referências">Referências</h3>

<ul>
  <li>ICH Q2(R2) Guideline on validation of analytical procedures.</li>
  <li>ICH Q2(R2): Training Module 3: Practical Applications of ICH Q2(R2).</li>
  <li>USP 1210 STATISTICAL TOOLS FOR PROCEDURE VALIDATION.</li>
  <li>RDC 166/2017 Dispõe sobre a validação de métodos analíticos e dá outras providências.</li>
</ul>

<p><br /></p>
<blockquote>
  <p><strong>Gostou do artigo?</strong></p>

  <p>Curta ou compartilhe sua opinião na publicação. 
Conecte-se no LinkedIn para acompanhar novas publicações 
sobre desenvolvimento analítico, estatística e ferramentas 
computacionais aplicadas à indústria farmacêutica.</p>
</blockquote>

<p><br /></p>
<blockquote>
  <p><strong>Continue explorando</strong></p>

  <p><a href="/">Ver outros posts</a></p>
</blockquote>]]></content><author><name></name></author><summary type="html"><![CDATA[A precisão de um procedimento analítico expressa a proximidade de concordância (grau de dispersão) entre uma série de medições obtidas a partir de múltiplas amostragens de uma mesma amostra homogênea sob as condições prescritas. A precisão pode ser considerada em três níveis: repetibilidade, precisão intermediária e reprodutibilidade [ICHQ2(R2)].]]></summary></entry><entry><title type="html">Probabilidade de Resultados Fora da Especificação a partir do Índice de Capacidade do Processo</title><link href="/2024/11/20/2024-11-20-prob-oos.html" rel="alternate" type="text/html" title="Probabilidade de Resultados Fora da Especificação a partir do Índice de Capacidade do Processo" /><published>2024-11-20T21:06:00+00:00</published><updated>2024-11-20T21:06:00+00:00</updated><id>/2024/11/20/2024-11-20-prob-oos</id><content type="html" xml:base="/2024/11/20/2024-11-20-prob-oos.html"><![CDATA[<p><img src="/images/capacidade.png" alt="razao de equacoes" /></p>

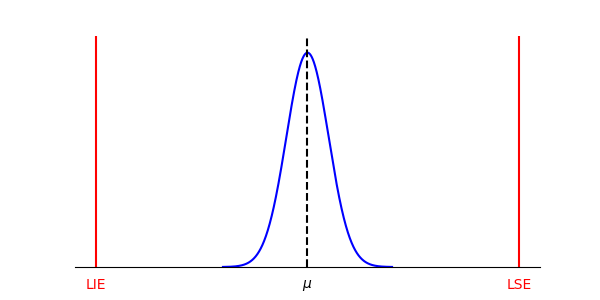
<p>Olá a todos, hoje vamos encontrar um modo de obter a probabilidade de se obter resultados fora da especificação (OOS) a partir do índice de capacidade do processo \(C_p\).</p>

<p><strong>Vamos lá!</strong></p>

<h1 id="índice-de-capacidade-do-processo">Índice de capacidade do processo</h1>

<p>O índice de capacidade de processo é dado por,</p>

\[C_p = \frac{LSE-LIE}{6\times\sigma} \tag{1}\]

<p>sendo:</p>

<p>\(LIE\): Limite inferior da especificação <br />
\(LSE\): Limite superior da especificação <br />
\(\sigma\): desvio-padrão natural do processo <br /></p>

<p>Podemos encontrar \(\sigma\) isolando na equação acima:</p>

\[\sigma = \frac{LSE-LIE}{6\times C_p} \tag{2}\]

<h1 id="probabilidade">Probabilidade</h1>

<p>Seja \(X\) a variável aleatória que representa o teor, portanto,
a probabilidade de se obter resultados fora da especificação será dada por,</p>

\[Prob(OOS) = Prob(X&lt;LIE) + Prob(X&gt;LSE)\,. \tag{3}\]

<p>Supondo uma distribuição simétrica</p>

\[Prob(OOS) = 2\times Prob(X&lt;LIE) \tag{4}\]

<p>Para calcular \(Prob(X&lt;LIE)\) usamos a variável padronizada \(z_{LIE} = \frac{LIE-\mu}{\sigma}\), assim:</p>

\[Prob(X&lt;LIE) = Prob(Z&lt;z_{LIE}) \\ = P\left(Z&lt;\frac{LIE-\mu}{\sigma}\right) = \Phi\left(\frac{LIE-\mu}{\sigma}\right) \tag{5}\]

<p>em que \(Z = \frac{X-\mu}{\sigma} \sim N(0,1)\) e \(\Phi\) representa a função de distribuição acumulada da normal padrão.</p>

<p>Substituindo (5) em (4)</p>

\[Prob(OOS) = 2\times \Phi\left(\frac{LIE-\mu}{\sigma}\right) \tag{6}\]

<p>Substituindo \(\sigma\) (Equação 2) em (6)</p>

\[Prob(OOS) = 2\times \Phi\left(6\times C_p\times\frac{LIE-\mu}{LSE-LIE}\right) \tag{7}\]

<p><strong>Muita atenção agora!</strong></p>

<p>Considerando o intervalo \([LIE;LSE]\) simétrico, \(\mu\) também será o centro desse intervalo, portanto \(-(LIE-\mu)\) representa metade da distância \(LSE-LIE\), assim,</p>

\[\frac{LIE-\mu}{LSE-LIE} = -\frac{1}{2} \tag{8}\]

<p>logo,</p>

\[Prob(OOS) = 2\times \Phi\left(-6\times C_p\times\frac{1}{2}\right) \tag{9}\]

<p>e finalmente</p>

\[\boxed{
Prob(OOS) = 2\times \Phi\left(-3\times C_p \right)
} \tag{10}\]

<h1 id="referências">Referências</h1>

<p>USP Capítulo Geral &lt;1033&gt; BIOLOGICAL ASSAY VALIDATION</p>

<p><br /></p>
<blockquote>
  <p><strong>Gostou do artigo?</strong></p>

  <p>Curta ou compartilhe sua opinião na publicação. 
Conecte-se no LinkedIn para acompanhar novas publicações 
sobre desenvolvimento analítico, estatística e ferramentas 
computacionais aplicadas à indústria farmacêutica.</p>
</blockquote>

<p><br /></p>
<blockquote>
  <p><strong>Continue explorando</strong></p>

  <p><a href="/">Ver outros posts</a></p>
</blockquote>]]></content><author><name></name></author><summary type="html"><![CDATA[]]></summary></entry><entry><title type="html">Fórmula para Quantificação de Impurezas - HPLC</title><link href="/jekyll/update/2024/11/18/2024-11-18-impurezas-hplc.html" rel="alternate" type="text/html" title="Fórmula para Quantificação de Impurezas - HPLC" /><published>2024-11-18T14:52:00+00:00</published><updated>2024-11-18T14:52:00+00:00</updated><id>/jekyll/update/2024/11/18/2024-11-18-impurezas-hplc</id><content type="html" xml:base="/jekyll/update/2024/11/18/2024-11-18-impurezas-hplc.html"><![CDATA[<p><img src="/images/impurities.png" alt="razao de equacoes" /></p>

<p>Hoje vamos deduzir as expressões para quantificação de impurezas em Produto Acabado e Insumo Farmacêutico Ativo.</p>

<p>A fórmula ficará dependente da concentração de um padrão para o ativo e do fator resposta relativo (\(F\))</p>

<p>Existem algumas vantagens em quantificar as impurezas utilizando o fator resposta relativo, por exemplo:</p>

<ul>
  <li>Não é necessário possuir os padrões de impurezas, uma vez que se conheça o \(F\) e o método esteja validado;</li>
  <li>Diminuição de custos com impurezas;</li>
  <li>Útil quando a impureza é pouco estável em solução.</li>
</ul>

<h1 id="concentração-de-impurezas">Concentração de impurezas</h1>

<p>Cumprindo-se a Lei de Lambert-beer, a área do analíto é então proporcional a sua concentração.</p>

<p>Logo, a área de um padrão, \(A_{pd}\), se relacionará com sua concentração, \(C_{pd}\), por meio do fator resposta, \(k_{pd}\), como</p>

\[\color{blue}{
A_{pd} = k_{pd} C_{pd}
} \tag{1}\]

<p>Também, a área de uma impureza, \(A_{imp}\), se relacionará com sua concentração, \(C_{imp}\), por meio do fator resposta, \(k_{imp}\), como</p>

\[\color{red}{
A_{imp} = k_{imp} C_{imp}
} \tag{2}\]

<p>Dividindo a Equação (2) pela (1), resulta,</p>

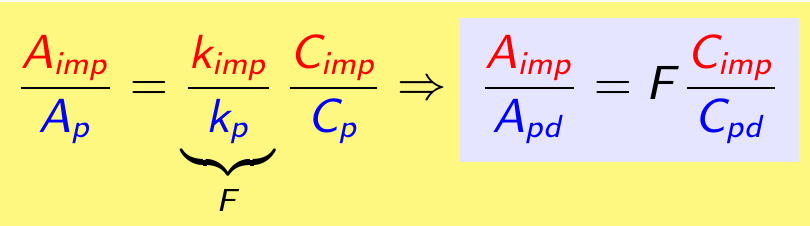
\[{
\frac{\color{red}{A_{imp}}}{\color{blue}{A_{pd}}} = \underbrace{\frac{\color{red}{k_{imp}}}{\color{blue}{k_{pd}}}}_{F}
 \frac{\color{red}{C_{imp}}}{\color{blue}{C_{pd}}}
\Rightarrow 
{
\frac{\color{red}{A_{imp}}}{\color{blue}{A_{pd}}} = {F} \frac{\color{red}{C_{imp}}}{\color{blue}{C_{pd}}}
}
} \tag{3}\]

<p>em que, \(F\) é o fator resposta relativo.</p>

<p>Isolando \(C_{imp}\) em</p>

\[{
\frac{\color{red}{A_{imp}}}{\color{blue}{A_{pd}}} = {F} \frac{\color{red}{C_{imp}}}{\color{blue}{C_{pd}}} \tag{4}
}\]

<p>resulta</p>

\[{
\color{red}{C_{imp}} = \color{blue}{C_{pd}} \frac{\color{red}{A_{imp}}}{\color{blue}{A_{pd}}}
\frac{1}{F} \tag{5}
}\]

<p>que é a expressão para concentração de impurezas na amostra.</p>

<h1 id="impurezas-para-produto-acabado">Impurezas para Produto Acabado</h1>

<p>Para um Produto Acabado pode se expressar a quantidade de impurezas como um percentual em relação a quantidade de ativo nominal na tomada de ensaio.</p>

<p>Desta forma, se define,</p>

\[{
Imp(\%) = 100 \times \frac{m_{imp}}{m_{ativ}^{nom}} =  100 \times \frac{C_{imp}}{C_{ativ}^{nom}} \tag{6} 
}\]

<p>Substituindo a Equação (5) na (6) obtém-se a equação desejada,</p>

\[\boxed
{
Imp(\%) = 100 \times \frac{\color{blue}{C_{pd}}}{C_{ativ}^{nom}} \frac{\color{red}{A_{imp}}}{\color{blue}{A_{pd}}} \frac{1}{F}
}\tag{7}\]

<h1 id="impurezas-para-a-ifa">Impurezas para a IFA</h1>

<p>Para um Insumo Farmacêutico Ativo (IFA) pode se expressar a quantidade de impurezas como um percentual em relação a massa tomada do IFA.</p>

<p>Desta forma, se define,</p>

\[{
Imp(\%) = 100 \times \frac{m_{imp}}{m_{IFA}} =  100 \times \frac{C_{imp}}{C_{IFA}} \tag{8}
}\]

<p>em que \(m_{IFA}\) é a massa de IFA tomada (tal qual).</p>

<p>Substituindo a Equação (5) na (8) obtém-se a equação desejada,</p>

\[\boxed
{
Imp(\%) = 100 \times \frac{\color{blue}{C_{pd}}}{C_{IFA}} \frac{\color{red}{A_{imp}}}{\color{blue}{A_{pd}}} \frac{1}{F} 
}\tag{9}\]

<h1 id="conclusão">Conclusão</h1>

<ul>
  <li>As expressões para quantificação de impurezas em Produto Acabado e Matéria-Prima foram deduzidas (Equações 7 e 9).</li>
  <li>Os percentuais de impurezas foram claramente definidos nas Equações (6) e (8).</li>
</ul>

<p><br /></p>
<blockquote>
  <p><strong>Gostou do artigo?</strong></p>

  <p>Curta ou compartilhe sua opinião na publicação. 
Conecte-se no LinkedIn para acompanhar novas publicações 
sobre desenvolvimento analítico, estatística e ferramentas 
computacionais aplicadas à indústria farmacêutica.</p>
</blockquote>

<p><br /></p>
<blockquote>
  <p><strong>Continue explorando</strong></p>

  <p><a href="/">Ver outros posts</a></p>
</blockquote>]]></content><author><name></name></author><category term="jekyll" /><category term="update" /><summary type="html"><![CDATA[]]></summary></entry></feed>