Teste para Agrupamento de Lotes em Estudos de Estabilidade (ANCOVA) e Tempo de Prateleira
O ICH Topic Q 1 E (Evaluation of Stability Data) apresenta o trecho abaixo, que descreve o procedimento estatístico recomendado para decidir se os dados de diferentes lotes podem ser agrupados em uma análise de estabilidade:
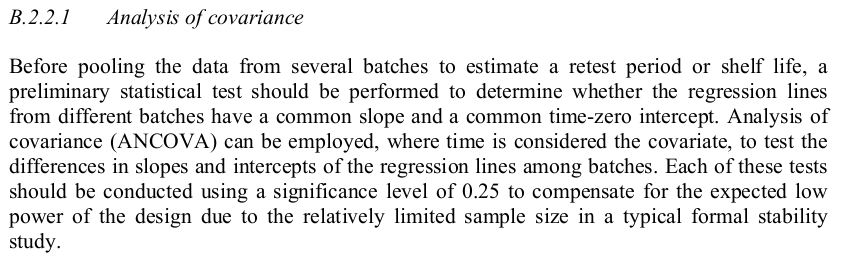
Como exercício de aprendizagem para esse procedimento estatístico, vamos reproduzir um exemplo completo em R: da análise de covariância (ANCOVA) até a estimativa do tempo de prateleira (shelf life).
Os dados
Considere os dados abaixo, que apresentam o teor (Resp) como percentual do valor declarado, medido em três tempos (0, 3 e 6 meses) para três lotes (1, 2 e 3). Cada lote possui três réplicas em cada tempo.
df <- data.frame(
  Resp = c(
    99.54, 99.19, 100.36,
    100.07, 99.10, 100.65,
    99.86, 99.71, 99.21,
    99.63, 98.86, 100.32,
    99.02, 100.31, 98.51,
    98.81, 99.65, 100.43,
    99.06, 98.29, 99.28,
    97.85, 98.35, 97.35,
    98.87, 98.79, 97.65
  ),
  Tempo = rep(c(0, 3, 6), each = 9),
  Lote = rep(rep(1:3, each = 3), times = 3)
)

# Converter Lote para fator
df$Lote <- factor(df$Lote)

print(head(df))
    Resp Tempo Lote
1  99.54     0    1
2  99.19     0    1
3 100.36     0    1
4 100.07     0    2
5  99.10     0    2
6 100.65     0    2
Passo 1: testando a homogeneidade das inclinações
A análise pode ser feita com soma de quadrados (SQ) tipo I ou tipo III. Aqui usaremos a tipo I, que reproduz os resultados obtidos pelo Minitab, software amplamente usado nesse tipo de cálculo de estabilidade. Um detalhe importante é que, para dados balanceados como os deste exemplo, a SQ tipo I não depende da ordem dos termos no modelo.
No R, a análise de covariância (ANCOVA) é obtida pelo código abaixo. O termo de interação Tempo*Lote é incluído porque queremos, nesta primeira etapa, um ajuste com inclinações (slopes) e interceptos livres para cada lote:
# slope e intercepto livres para cada lote
modelo_completo <- lm(Resp ~ Tempo * Lote, data = df)
print(anova(modelo_completo))
Analysis of Variance Table

Response: Resp
           Df Sum Sq Mean Sq F value    Pr(>F)
Tempo       1 8.2689  8.2689 18.2671 0.0003374 ***
Lote        2 0.6133  0.3066  0.6774 0.5187026
Tempo:Lote  2 1.2987  0.6493  1.4345 0.2606467
Residuals  21 9.5060  0.4527
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Como o p-valor da interação Tempo:Lote (0,2606) é maior que o nível de significância de 0,25 recomendado pelo ICH Topic Q 1 E, não há evidência de que as inclinações difiram entre os lotes. Podemos, então, seguir para o modelo com inclinação única.
Passo 2: testando a homogeneidade dos interceptos
Basta ajustar um novo modelo, agora sem o termo de interação, mantendo uma inclinação comum e interceptos livres por lote:
# slope em comum e intercepto livre por lote
modelo_slope_unico <- lm(Resp ~ Tempo + Lote, data = df)
print(anova(modelo_slope_unico))
Analysis of Variance Table

Response: Resp
           Df  Sum Sq Mean Sq F value    Pr(>F)
Tempo       1  8.2689  8.2689 17.6021 0.0003459 ***
Lote        2  0.6133  0.3066  0.6527 0.5300062
Residuals  23 10.8047  0.4698
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Agora o p-valor para Lote (0,5300) também é maior que 0,25, ou seja, não há evidência de que os interceptos difiram entre os lotes. Isso significa que os três lotes podem ser agrupados em um único modelo.
Passo 3: modelo final com lotes agrupados
Com inclinação e intercepto comuns, o modelo final considera todos os lotes simultaneamente:
# slope e intercepto em comum para todos os lotes
modelo_agrupado <- lm(Resp ~ Tempo, data = df)
print(anova(modelo_agrupado))
Analysis of Variance Table

Response: Resp
          Df  Sum Sq Mean Sq F value    Pr(>F)
Tempo      1  8.2689  8.2689  18.105 0.0002568 ***
Residuals 25 11.4179  0.4567
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Os coeficientes desse ajuste são obtidos por:
print(modelo_agrupado)
Call:
lm(formula = Resp ~ Tempo, data = df)

Coefficients:
(Intercept)        Tempo
    99.8896      -0.2259
Ou seja, o modelo agrupado resulta na equação:
\[\text{Resp} = 99{,}8896 - 0{,}2259 \times \text{Tempo}\]Estimando o tempo de prateleira (shelf life)
Com o modelo agrupado em mãos, podemos estimar “por extrapolação” o tempo de prateleira. O shelf life é definido como o ponto em que o limite inferior de confiança para a reta verdadeira intercepta o limite inferior de especificação (LIE), aqui considerado como 95% do valor declarado, com 95% de confiança unilateral.
Esse ponto pode ser obtido resolvendo uma equação quadrática de forma exata, mas também é possível encontrá-lo numericamente, buscando o valor de tempo em que o limite inferior do intervalo de confiança cruza o LIE. Para isso, primeiro calculamos o intervalo de confiança em uma grade fina de tempos:
# Novos tempos para previsão
novos_tempos <- data.frame(Tempo = seq(0, 30, length.out = 50000))

# Intervalo de confiança (90% bilateral = 95% unilateral)
pred <- predict(modelo_agrupado,
                 newdata = novos_tempos,
                 interval = "confidence",
                 level = 0.90)

print(head(pred))
      fit      lwr      upr
1 99.88963 99.53836 100.2409
2 99.88949 99.53827 100.2407
3 99.88936 99.53818 100.2405
4 99.88922 99.53808 100.2404
5 99.88909 99.53799 100.2402
6 99.88895 99.53790 100.2400
O valor “exagerado” de 50.000 pontos serve apenas para ganharmos precisão na estimativa do ponto de cruzamento. Agora identificamos o primeiro tempo em que o limite inferior do IC fica abaixo do LIE:
LIE <- 95

idx <- which(pred[, "lwr"] < LIE)[1]
shelf_life <- novos_tempos$Tempo[idx]

cat(sprintf("Shelf-life estimado: %.2f meses", shelf_life))
Shelf-life estimado: 16.24 meses
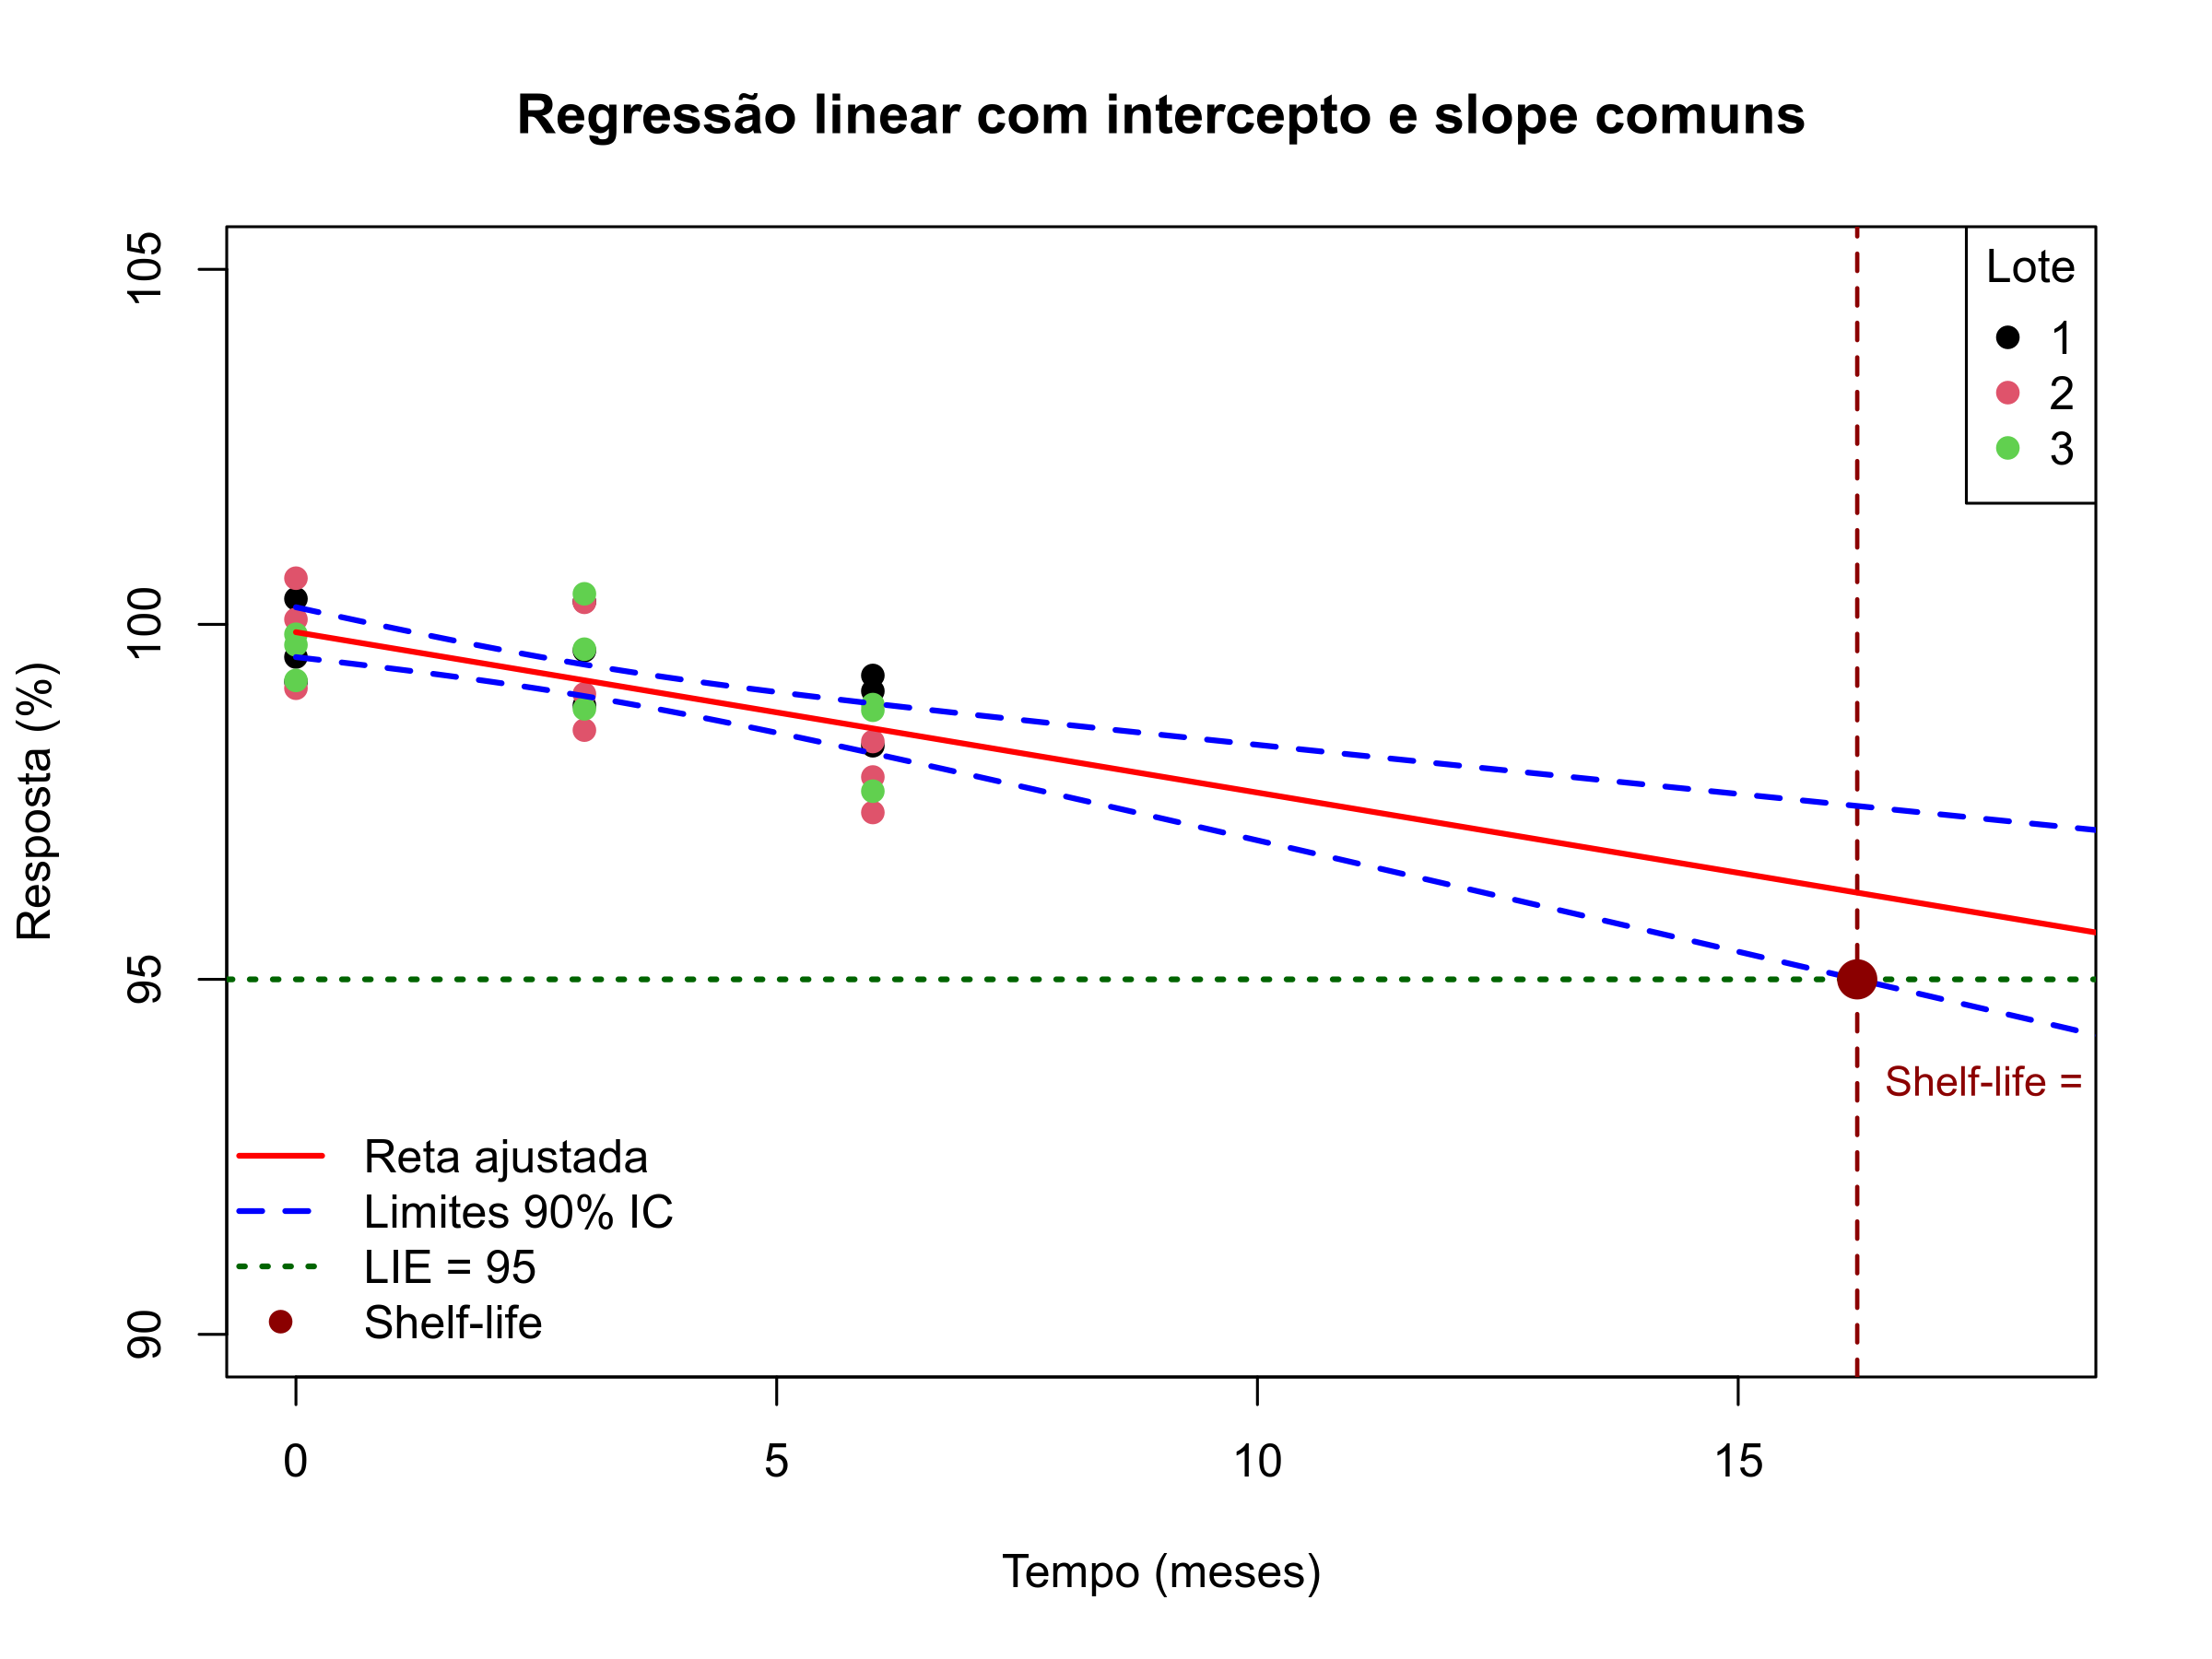
O tempo de prateleira estimado é de 16,24 meses. A interpretação é a de que há 95% de confiança de que a média verdadeira da resposta (equivalentemente, o percentil 50% sob normalidade) não esteja abaixo de 95% do valor declarado antes desse período.
Visualizando os resultados
Por fim, podemos representar graficamente o ajuste, os limites de confiança e o ponto correspondente ao tempo de prateleira:
# Gráfico base: dispersão dos dados coloridos por lote
plot(df$Tempo, df$Resp,
     col = as.numeric(df$Lote),
     xlab = "Tempo (meses)",
     ylab = "Resposta (%)",
     main = "Regressão linear com intercepto e slope comuns",
     xlim = c(0, 18),
     ylim = c(90, 105),
     pch = 19)

# Linha horizontal do LIE
abline(h = LIE, col = "darkgreen", lty = 3, lwd = 2)

# Linha vertical no shelf life
abline(v = shelf_life, col = "darkred", lty = 2, lwd = 1.5)

# Reta ajustada
lines(novos_tempos$Tempo, pred[, "fit"], col = "red", lwd = 2)

# Limites de confiança (90% bilateral = 95% unilateral)
lines(novos_tempos$Tempo, pred[, "lwr"], col = "blue", lty = 2, lwd = 2)
lines(novos_tempos$Tempo, pred[, "upr"], col = "blue", lty = 2, lwd = 2)

# Ponto de interseção (shelf life)
points(shelf_life, LIE, col = "darkred", pch = 19, cex = 1.8)

# Anotação com o valor do shelf life
text(shelf_life, LIE - 1.5,
     labels = paste0("Shelf-life = ", round(shelf_life, 2), " meses"),
     col = "darkred", cex = 0.9, pos = 4)

# Legenda dos lotes
legend("topright",
       legend = levels(df$Lote),
       col = 1:length(levels(df$Lote)),
       pch = 19,
       title = "Lote")

# Legenda das curvas e do shelf life
legend("bottomleft",
       legend = c("Reta ajustada", "Limites 90% IC",
                  "LIE = 95", "Shelf-life"),
       col = c("red", "blue", "darkgreen", "darkred"),
       lty = c(1, 2, 3, NA),
       pch = c(NA, NA, NA, 19),
       lwd = c(2, 2, 2, NA),
       bty = "n")
Conclusão
Seguindo a abordagem hierárquica recomendada pelo ICH Topic Q 1 E, testamos primeiro a homogeneidade das inclinações entre lotes e, em seguida, a homogeneidade dos interceptos, usando o nível de significância de 0,25 sugerido pela guideline. Como nenhum dos dois testes indicou diferença significativa, os três lotes puderam ser agrupados em um único modelo de regressão, o que resultou em uma estimativa de tempo de prateleira de 16,24 meses, mais robusta do que estimativas obtidas lote a lote separadamente, por aproveitar toda a informação disponível no estudo.
Gostou do artigo? Gostaria de ver os outros casos?
Curta ou compartilhe sua opinião na publicação. Conecte-se no LinkedIn para acompanhar novas publicações sobre desenvolvimento analítico, estatística e ferramentas computacionais aplicadas à indústria farmacêutica.
Continue explorando